# 9Router — roteador de IA GRATUITO e economizador de tokens
**Nunca pare de codificar. Economize 20-40% de tokens com RTK + fallback automático para modelos de IA GRATUITOS e baratos.**
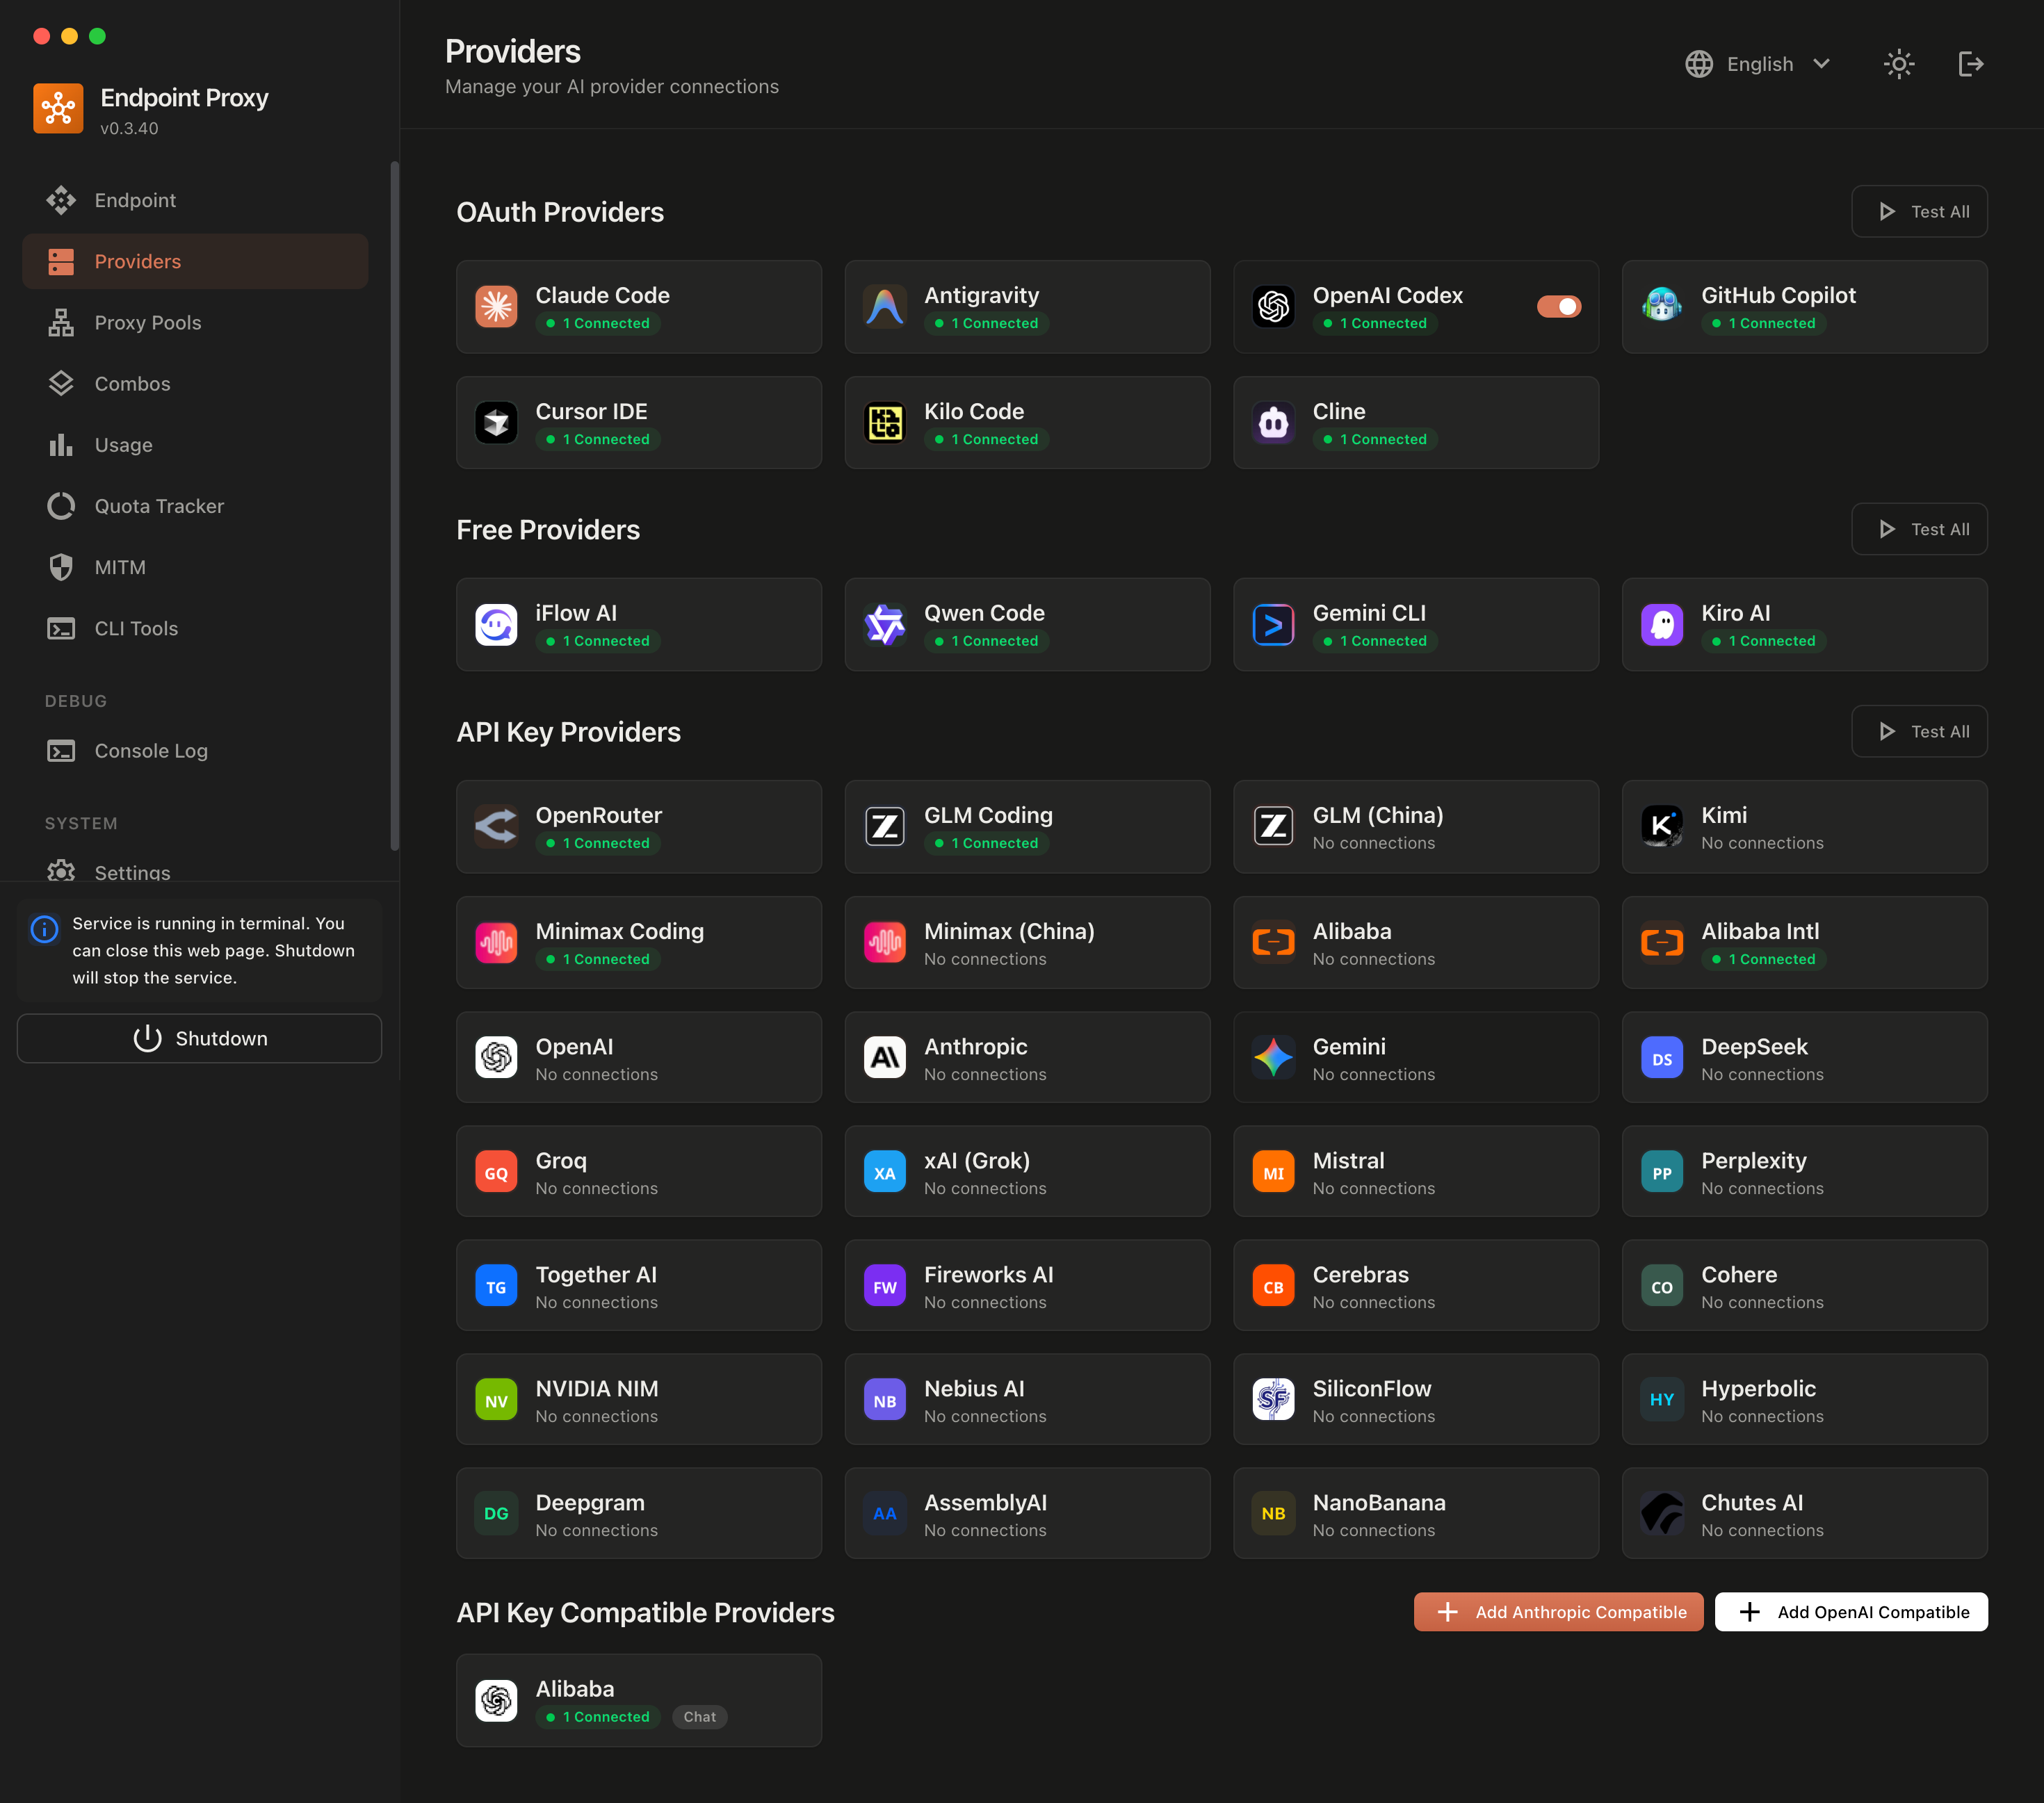
**Conecte todas as ferramentas de código de IA (Claude Code, Cursor, Antigravity, Copilot, Codex, Gemini, OpenCode, Cline, OpenClaw...) a mais de 40 provedores de IA e mais de 100 modelos.**
[](https://www.npmjs.com/package/9router)
[](https://www.npmjs.com/package/9router)
[](https://hub.docker.com/r/decolua/9router)
[](https://github.com/decolua/9router/pkgs/container/9router)
[](https://github.com/decolua/9router/blob/main/LICENSE)

[🚀 Início rápido](#-início-rápido) • [💡 Recursos](#-principais-recursos) • [📖 Configuração](#-guia-de-configuração) • [🌐 Site](https://9router.com)
[🇺🇸 English](../README.md) • [🇻🇳 Tiếng Việt](./README.vi.md) • [🇨🇳 中文](./README.zh-CN.md) • [🇯🇵 日本語](./README.ja-JP.md) • [🇷🇺 Русский](./README.ru.md) • [🇹🇭 ไทย](./README.th.md) • [🇮🇷 فارسی](./README.fa_IR.md) • [🇮🇩 Indonesia](./README.id-ID.md)
---
## 🤔 Por que 9Router?
**Pare de desperdiçar dinheiro, tokens e atingir limites:**
- ❌ A cota de assinatura expira sem ser utilizada todos os meses
- ❌ Os limites de requisições interrompem você durante a programação
- ❌ Saídas de ferramentas (`git diff`, `grep`, `ls`...) consomem tokens rapidamente
- ❌ APIs caras ($20–50/mês por provedor)
- ❌ Troca manual entre provedores
**9Router resolve isso:**
- ✅ **RTK Token Saver** - Compactação automática do conteúdo de `tool_result`, economize 20-40% de tokens por solicitação
- ✅ **Maximize as assinaturas** - Rastreie a cota, aproveite toda a cota antes da renovação
- ✅ **Auto fallback** - Assinatura → Econômico → Gratuito, sem tempo de inatividade
- ✅ **Múltiplas contas** - Round-robin entre contas por provedor
- ✅ **Universal** - Funciona com Claude Code, Codex, Cursor, Cline, qualquer ferramenta CLI
---
## 🔄 Como funciona
```
┌─────────────┐
│ Sua CLI │ (Claude Code, Codex, OpenClaw, Cursor, Cline...)
│ Ferramenta│
└──────┬──────┘
│ http://localhost:20128/v1
↓
┌─────────────────────────────────────────────┐
│ 9Router (Roteador inteligente) │
│ • RTK Token Saver (reduz tokens de `tool_result`) │
│ • Tradução de formatos (OpenAI ↔ Claude) │
│ • Acompanhamento de cotas │
│ • Renovação automática de token │
└──────┬──────────────────────────────────────┘
│
├─→ [Nível 1: ASSINATURA] Claude Code, Codex, GitHub Copilot
│ ↓ cota esgotada
├─→ [Nível 2: ECONÔMICO] GLM ($0.6/1M), MiniMax ($0.2/1M)
│ ↓ limite de orçamento
└─→ [Nível 3: GRATUITO] Kiro, OpenCode Free, Vertex ($300 em créditos)
Resultado: programe sem interrupções, com custo mínimo e economia de 20% a 40% dos tokens via RTK
```
---
## ⚡ Início rápido
**1. Instale globalmente:**
```bash
npm install -g 9router
9router
```
🎉 O painel abre em `http://localhost:20128`
**2. Conecte um provedor GRATUITO (sem necessidade de inscrição):**
Painel → Provedores → Conecte **Kiro AI** (~50 créditos/mês grátis: Claude 4.5 + GLM-5 + MiniMax) ou **OpenCode Free** (sem autenticação) → Pronto!
**3. Use em sua ferramenta CLI:**
```
Configurações do Claude Code/Codex/OpenClaw/Cursor/Cline:
Endpoint: http://localhost:20128/v1
API Key: [copie do painel]
Model: kr/claude-sonnet-4.5
```
**É isso aí!** Comece a codificar com modelos de IA GRATUITOS.
**Alternativa: executar a partir do código-fonte (este repositório):**
Este pacote de repositório é privado (`9router-app`), portanto, a execução pelo código-fonte/Docker é o caminho de desenvolvimento local esperado.
```bash
cp .env.example .env
npm install
PORT=20128 NEXT_PUBLIC_BASE_URL=http://localhost:20128 npm run dev
```
Modo de produção:
```bash
npm run build
PORT=20128 HOSTNAME=0.0.0.0 NEXT_PUBLIC_BASE_URL=http://localhost:20128 npm run start
```
URLs padrão:
- Painel: `http://localhost:20128/dashboard`
- API compatível com OpenAI: `http://localhost:20128/v1`
---
## Guias de vídeo
### 🏠 Provedores auto-hospedados
Para fala e incorporações veiculadas em **sua própria** máquina — whisper.cpp,
faster-whisper, Speaches, Kokoro-FastAPI, openai-speech, llama.cpp/llama-server,
vLLM, Infinity, text-embeddings-inference ou qualquer outro serviço compatível com o formato OpenAI.
| Provedor | Ponto final usado | Servidor típico |
| --- | --- | --- |
| **STT auto-hospedado** | `/v1/audio/transcriptions` | whisper.cpp, faster-whisper |
| **TTS auto-hospedado** | `/v1/audio/speech` | Kokoro-FastAPI, openedai-speech |
| **Incorporação auto-hospedada** | `/v1/embeddings` | llama-server, vLLM, Infinity |
Todos os outros provedores de voz são um serviço de nuvem nomeado com um endpoint fixo. Estes
três leem seus endereços de **cada conexão**, para que um provedor possa apontar para
várias máquinas e balanceamento de carga entre elas como qualquer outra.
Defina-o na conexão como `providerSpecificData.baseUrl`:
| Provedor | Informe | Resultado |
| --- | --- | --- |
| STT auto-hospedado | o URL completo — `http://host:8080/v1/audio/transcriptions` | usado como está |
| TTS auto-hospedado | a raiz do servidor — `http://host:8880` | `+ /v1/audio/speech` |
| Incorporação auto-hospedada | a **base OpenAI**, `/v1` incluída — `http://host:8080/v1` | `+ /embeddings` |
> **Cuidado com `/v1` em embeddings.** O adaptador anexa `/embeddings`, então
> `http://host:8080` resolve para `http://host:8080/embeddings` e perde o
> rota OpenAI – o llama-server responde **501**. Dê a ele o mesmo URL base de um OpenAI
> o cliente usaria. Um `.../v1/embeddings` completo também é aceito, então um valor colado
> de um exemplo `curl` também funciona.
A chave API não é verificada pela maioria dos servidores locais, mas o campo não deve estar vazio:
é o que dá à conexão um registro de credenciais, e `baseUrl` reside lá.
Qualquer espaço reservado funciona.
A incorporação auto-hospedada **não tem fallback na nuvem por design** — uma conexão salva
sem um `baseUrl` é relatado como um erro de configuração, em vez de silenciosamente
voltando para `api.openai.com`, que enviaria seu texto de entrada e chave de API para
terceiros por meio de um provedor chamado "Auto-hospedado".
---
## 💡 Principais recursos
| Recurso | O que faz | Por que é importante |
| --------------------------------------------------------------------------------- | ---------------------------------------------------------------------------------------- | ------------------------------------------------- |
| 🚀 **RTK Token Saver** ([RTK](https://github.com/rtk-ai/rtk) ⭐40K) | Compactar saídas de ferramentas (`git diff`, `grep`, `ls`, `tree`...) antes de enviar para LLM | Economize **20-40% de tokens de entrada** por solicitação |
| 🧠 **Headroom Token Saver** ([Headroom](https://github.com/chopratejas/headroom)) | Proxy `/v1/compress` externo opcional antes do roteamento do provedor | Economize mais tokens de contexto sem alterar clientes |
| 🪨 **Modo Caveman** ([Caveman](https://github.com/JuliusBrussee/caveman) ⭐52K) | Injetar prompt de fala do homem das cavernas → Respostas do LLM concisas, substância técnica preservada | Economize **até 65% de tokens de produção** |
| 🐴 **Ponytail** ([Ponytail](https://github.com/DietrichGebert/ponytail)) | Injetar prompt "lazy senior dev" → LLM escreve código mínimo YAGNI primeiro (Lite/Full/Ultra) | **Menos tokens de saída, menos refatoração** |
| 🎯 **Fallback inteligente de 3 camadas** | Rota automática: Assinatura → Barato → Grátis | Nunca pare de codificar, tempo de inatividade zero |
| 📊 **Acompanhamento de cotas em tempo real** | Contagem de tokens ao vivo + contagem regressiva de redefinição | Maximizar o valor da assinatura |
| 🔄 **Tradução de formato** | OpenAI ↔ Claude ↔ Gemini ↔ Cursor ↔ Kiro ↔ Vertex | Funciona com qualquer ferramenta CLI |
| 👥 **Suporte para múltiplas contas** | Várias contas por provedor | Balanceamento de carga + redundância |
| 🔄 **Atualização automática de token** | Os tokens OAuth são atualizados automaticamente | Não é necessário fazer novo login manual |
| 🎨 **Combos Personalizados** | Crie combinações ilimitadas de modelos | Adapte o fallback às suas necessidades |
| 📝 **Registro de requisições** | Modo de depuração com logs completos de solicitação/resposta | Solucione problemas facilmente |
| 💾 **Sincronização na nuvem** | Sincronizar configuração entre dispositivos | Mesma configuração em todos os lugares |
| 📊 **Análise de uso** | Acompanhe tokens, custos e tendências ao longo do tempo | Otimizar gastos |
| 🌐 **Implante em qualquer lugar** | Localhost, VPS, Docker, Cloudflare Workers | Opções flexíveis de implantação |
Configure `X-9Router-Token-Saver: off` para ignorar todos os economizadores de tokens para uma solicitação de chat.